
Abhängigkeiten
Im Transformation Editor werden alle Transformationen erfasst. Zusätzlich zur Transformation wird angegeben, welche Quellen verwendet werden und in welche Ziele mit einer Transformation geschrieben wird. Innerhalb eines Blatts erkennt man visuell den Datenfluss und damit, in welcher Reihenfolge die Transformationen sinnvollerweise ablaufen sollten, damit verwendete Tabellen bereits gefüllt sind, bevor eine nachfolgende Transformation startet.
Abhängigkeiten zwischen Transformationen erkennt der datasqill Scheduler automatisch und berücksichtigt sie in der Ausführungsreihenfolge. Wenn Transformation B eine Tabelle liest, die Transformation A beschreibt, wartet B, bis A fertig ist.
Dazu müssen die beteiligten Transformationen in einem gemeinsamen Ausführungsrequest gebündelt sein. Das geschieht implizit, wenn sie auf demselben Arbeitsblatt liegen, oder explizit über einen gemeinsamen Batch.
Die Abhängigkeiten ergeben sich nicht aus der Gesamtmenge der modellierten Transformationen, sondern aus dem Inhalt des jeweiligen Ablaufs. Wird nur eine einzige Transformation gestartet, bleiben Abhängigkeiten zu Quelltabellen unberücksichtigt, weil die schreibenden Transformationen nicht Teil des Ablaufs sind. Es werden nur Abhängigkeiten zwischen den tatsächlich auszuführenden Transformationen ermittelt.
Abhängigkeiten bestehen nur zwischen Transformationen, werden aber über die verwendeten Objekte ermittelt. Innerhalb eines Arbeitsblatts und arbeitsblattübergreifend gelten unterschiedliche Regeln.
Beim Anlegen eines Ablaufs werden die Abhängigkeiten nach diesen Regeln ermittelt und in der Tabelle sqts_batch_instance_dependency persistiert. Solange nicht alle Tasks, von denen eine Task abhängt, im Status Finished sind, bleibt die abhängige Task im Status Dependency Wait.
Abhängigkeiten innerhalb eines Arbeitsblatts
Es gilt eine Regel:
Die Ablaufreihenfolge ergibt sich exakt aus den modellierten Verbindungen zwischen den Transformationen (blaue Kästchen).
Wenn Transformation B ein Objekt (graues Kästchen) verwendet, das Transformation A beschreibt, startet B erst, nachdem A erfolgreich abgeschlossen ist.
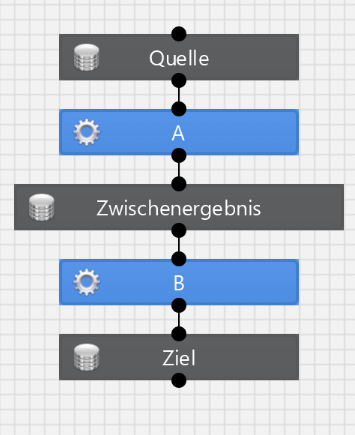
Die Einstellung Dependency am Objekt (Wait/Ignore) hat innerhalb eines Arbeitsblatts keine Bedeutung.
Abhängigkeiten in der Datenbank (zum Beispiel eine View, die eine Tabelle verwendet) werden innerhalb eines Arbeitsblatts nicht herangezogen. Sind Tabelle 1 und View 1 so modelliert:
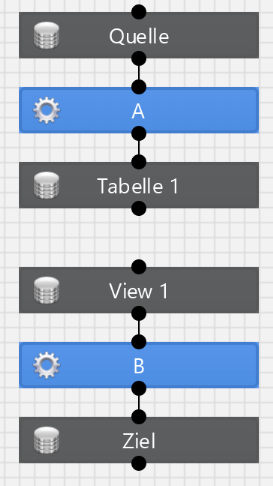
dann laufen die Transformationen A und B parallel, obwohl in der Datenbank eine Abhängigkeit besteht.
Soll diese Abhängigkeit gelten, muss man sie manuell modellieren:
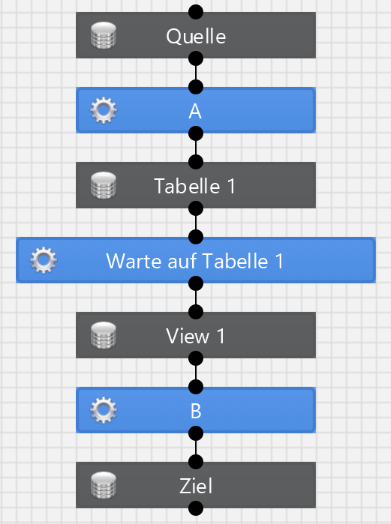
Die Transformation „Warte auf Tabelle 1“ ist eine virtuelle Transformation (Typ Virtual).
Objekte mit gleichem Namen
Innerhalb eines Arbeitsblatts ist es für die Ablaufreihenfolge unerheblich, ob dasselbe Datenbankobjekt (gleiche Connection, gleiches Schema, gleicher Name) mehrfach auf dem Blatt liegt. Aus Sicht des Ablaufs sind das unterschiedliche Objekte, weil sie unterschiedliche Zustände repräsentieren.
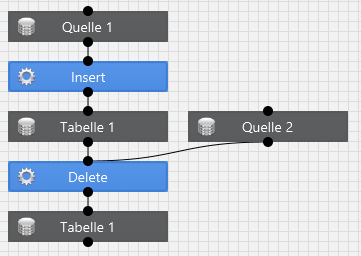
Hier wird eine Tabelle zuerst befüllt und danach werden Zeilen gelöscht. Die beiden Objekte „Tabelle 1“ sind in der Datenbank identisch, müssen im Ablauf aber nacheinander behandelt werden. Die Abhängigkeit ist modelliert.
Ohne modellierte Verbindung ist die Reihenfolge offen:
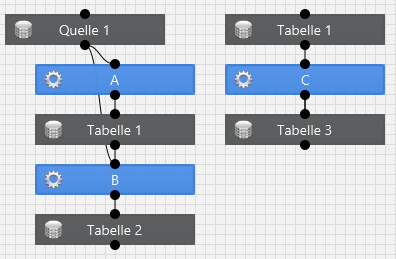
Hier ist nicht sichergestellt, in welchem Zustand Transformation C die Tabelle 1 vorfindet. Transformation A kann bereits gelaufen sein, noch nicht gelaufen sein oder zeitgleich mit C aktiv sein. Dieses Konstrukt verwendet man, wenn A und C auf unterschiedlichen Teilmengen derselben Tabelle arbeiten, zum Beispiel bei einer Steuertabelle mit einem eigenen Eintrag pro Transformationslogik.
Alle diese Fälle unterstreichen dieselbe Regel: Die Ablaufreihenfolge ergibt sich exakt aus den modellierten Verbindungen zwischen den Transformationen.
Arbeitsblattübergreifende Abhängigkeiten
Arbeitsblattübergreifende Abhängigkeiten werden ausschließlich über den Namen ermittelt. Derzeit werden nur Datenbankobjekte berücksichtigt. Connection, Schema und Tabellenname müssen übereinstimmen.
Regel 1: Ist am modellierten Objekt Dependency auf Ignore gesetzt, werden für Transformationen, die dieses Objekt verwenden, keine Abhängigkeiten aus anderen Arbeitsblättern mit gleichem Namen herangezogen.
Regel 2: Wird in das modellierte Objekt auf diesem Blatt geschrieben (Objekt als Ziel), werden für Transformationen, die dieses Objekt verwenden, keine weiteren Abhängigkeiten mit gleichem Namen aus anderen Arbeitsblättern herangezogen.
Regel 3: In allen anderen Fällen werden für Transformationen, die das Objekt verwenden, Abhängigkeiten mit gleichem Namen aus anderen Arbeitsblättern herangezogen.
Beispiel für Regel 2:
Arbeitsblatt 1
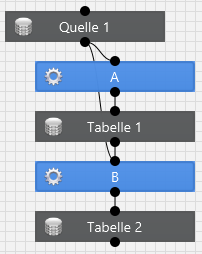
Arbeitsblatt 2
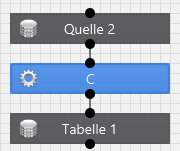
In diesem Beispiel wartet Transformation B nicht auf Transformation C.
Schleifen
Benötigt Transformation A direkt oder indirekt Transformation B und B umgekehrt A, entsteht eine Schleife (Deadlock). Der Ablauf erledigt alle Transformationen, die nicht in der Schleife liegen und nicht auf sie warten. Danach bleibt die Gesamtausführung auf Active, während die betroffenen Tasks im Status Dependency Wait stehen.
Die Auflösung muss manuell erfolgen: die Transformation, die zuerst laufen soll, in einem eigenen Ablauf starten und sie im blockierten Ablauf mit Skip Task überspringen.